記事一覧

2026-09-16 22:00:00

AIに任せる仕組みを作って、最後に残った時間 — 「文明の夜明け」の先で考えること

AIと小説をつくる仕組み・全8回 第8回

――任せられるようになったあと、自分はどこに関わりたいか
AIに任せる仕組みを作って、最後に残った時間 — 「文明の夜明け」の先で考えること

AIと小説をつくる仕組みを紹介する、全8回連載の第8回です。

前回の 「AIに小説を書いてもらう手順を設計する — ハーネスと、書き直すループ」 では、執筆担当AIエージェントが書いた原稿を、複数の評価担当AIエージェントが読み、 その指摘を次の改稿へつなぐ仕組みを紹介しました。

作品の目的や人物を設定ファイルに書き、読む順番や役割分担をハーネスとして整え、 評価と改稿のループを回す。一年間、小説を書くために取り組んできたことです。

仕組みが動くようになったとき、私は、このやり方に納得しました。 毎回の指示だけで長い物語を書き続けてもらうより、判断の根拠と仕事の手順を残しておく。 それを複数のAIエージェントが参照しながら、原稿を受け渡していく。 自分が目指していた制作の形が、かなり見えてきました。

同時に、ひとつのことに気づきました。

この仕組みで、いちばん時間がかかるのは、
私が読むところなのではないか。

最終回は、設定ファイルの外に残った、この時間について考えます。

1.任せられるようになって、自分が止めていると分かった

原稿を作る速さと、読む速さ

AIエージェントは、設定を読み、原稿を書き、評価をまとめます。 私が改稿を依頼すると、指摘を踏まえた次の版が作られます。

もちろん、設定と食い違うこともあります。評価が高くても、自分にはしっくりこない文章もあります。 それでも、原稿を作り直す速度は、私が一つひとつ読んで考える速度を上回ります。

制作工程だけを見れば、私はボトルネックです。

原稿ができても、私が読まなければ先へ進めません。 どの指摘を受け入れるか。直したことで、人物の言葉が自然になったか。 この文章を、自分の作品として送り出したいか。そこで時間がかかります。

仕組みを整える前は、どうすればAIに書き続けてもらえるかを考えていました。 書き続けられるようになると、今度は、自分がどこで止めているのかが見えてきました。

小説では、その時間を残したかった

ただ、小説では、その時間をなくしたいとは思いませんでした。

自分が読んで面白いと思うことも、私が小説を書く理由だからです。 ルミや莉子が何を言い、何を言わなかったのか。その場面を読み、自分の中に何が残るのか。 それを確かめる時間まで省いてしまったら、私にとっての創作の楽しみも減ってしまいます。

評価の点数は参考になります。 でも、点数を見ただけでは、自分がその小説を読んだことにはなりません。

読者が面白いと感じるかどうかは、一人ひとりに委ねるしかありません。 その前に、私自身が読んで、この作品を送り出そうと思えるか。その判断は残しておきたいのです。

工程を速くするうえでは待ち時間でも、私にとっては、作品に関わるための時間でした。

2.サイト制作では、違う場所で確かめていた

「文明の夜明け」を感じた体験

小説と並行して、Digital Supporters Clubの会員制クラブサイトも作っています。 その過程で経験したことを、 「ものづくりの時間が変わった――『文明の夜明け』を感じた」 という記事に書きました。

会員ごとのフォルダ作成や権限設定を支援する、小さな管理ツールの開発です。

AIはコードを書くだけでなく、そのコードを確かめるテストも作り、実行しました。 問題があれば修正し、またテストする。 テストに使う模擬的なSharePointの環境まで、コードとして用意していました。

作る、試す、直す、もう一度試す。

この一連の作業が、自分の知っていたシステム開発とは違う速度で進んでいきました。

私はプログラムを一行も書いていません。 それでも、自分が必要としている道具が形になり、動作を確かめるところまで進んでいく。 その様子を目の前にして、文明の夜明けを感じました。

コードを全部読む代わりに、動かして確かめる

このとき、私は生成されたコードをすべて読むことはしませんでした。

設計書には目を通しました。自分が頼んだ内容になっているかを確認し、実際の環境で動かしました。 しかし、小説の原稿を読むときのように、一行ずつ表現を味わう読み方ではありません。

小説では、文章そのものを読みたい。 管理ツールでは、必要な仕事が意図したとおりに行われるかを確かめたい。

同じ私でも、何を作るかによって、判断を入れる場所が違っていました。

コードを全部読む工程を通らなくても、開発は進みます。そのぶん、AIが書いて試す速さを生かせます。 ただ、AIによるテストが通っても、実際に使う環境で動くかどうかは、別に確かめる必要がありました。

テストの中では合っていても、現実とは違った

実際、AIが用意したテストを通過したあと、本物の日本語版SharePointで問題が見つかりました。

コードは、権限の名前が英語で返ってくる前提で作られていました。テスト用の模擬環境も、同じ前提でした。 両方が英語の名前を使うので、テストは通ります。

ところが、本物の環境からは日本語の表示名が返ってきました。

コードとテストが一致していることと、
現実に合っていることは違っていたのです。

私は実行結果をAIへ返しました。AIは表示言語に左右されない方法へコードを修正し、テストも追加しました。

ここで私が行ったのは、コードを自分の手で直すことではありません。 実際に使う環境で確かめ、見つかった違いを制作の工程へ戻すことでした。

この経験は、小説を書く仕組みにもつながります。 原稿と設定が一致しているかは確認できます。 しかし、それを読んで何を感じるかは、実際に読んでみなければ分かりません。

3.速さを受け入れながら、どこに関わるかを決める

人間の判断を待たない工程は増えていく

この二つの経験から、私は、人間が途中で判断する機会は、 仕事によってはこれからも減っていくと思うようになりました。

一つの作業が終わるたびに人が読み、確認し、次へ進む許可を出す。 その時間を省ければ、成果物ができるまでの時間は短くなります。 速さが経済的な価値を持つ環境では、確認を自動化できないか、まとめて行えないかと考えるのは自然です。

対象を限った作業であれば、依頼してから成果物ができるまで、 一度も人が判断を挟まない形も増えていくでしょう。

私は、それ自体を悪いことだとは考えていません。

何度も繰り返す処理や、結果を機械的に確かめられる作業まで、必ず人が待ち構えている必要はないからです。 一方で、人の確認を外したからといって、品質が自動的に上がるわけでもありません。 SharePointの経験では、コードとテストに共通する前提が、現実と食い違っていました。

自分の設定ファイルにも、確かめていない根拠があった

小説の調査記録でも、同じような問題に向き合いました。 AIが調べた情報をファイルに残し、執筆や評価の根拠にしていましたが、 出典のURLがあるだけでは、原典を直接読んで確かめたのか、 要約や解説を経由したのかが分かりません。

そこで、調査記録の一行ごとに確度ラベルを付けました。 どこまで確かめたかを、四段階で残します。

ラベル どこまで確かめたか 本文での扱い
A 法令や公的機関の一次資料を、原典で直接確認した 数字や条文の断定に使える
B 公的機関の情報だが、要約や解説を経由している 事実の方向は使える。数字はAへ上げてから出す
C 二次情報(解説記事、事業者の見解、まとめ記事) 本文で断定に使わない
D 未確認 本文で断定しない

数字を本文へ出すときは、その行がAであることを確認します。 BやCであれば、先に原典へ当たってAへ上げてから使います。

2026年9月6日の導入時、その日に追加した調査記録には、Aの行が一つもありませんでした。 これは、記録がすべて誤りだったという意味ではありません。 原典で直接確かめたと言える行が、まだなかったのです。

本文と調査記録を照合して一致していても、調査記録そのものの根拠が確かとは限りません。 ラベルを付けても、それだけで正しくなるわけではありません。原典に戻って確認する作業が必要です。

コードとテストの照合にも、本文と調査記録の照合にも、共通する限界がありました。
同じ前提を共有したもの同士を比べるだけでは、その前提の誤りを見逃すことがあるのです。

脅威という言葉だけでは、付き合い方は決まらない

文章、プログラム、設計書、画像。 AIが作ったり、制作に関わったりするものは、身の回りで増えていくと思います。 公開されたインターネットの情報だけでなく、仕事で使う資料や、自分だけが使う道具にも、 その変化は広がるでしょう。

私は、その変化を脅威という言葉だけで捉えたくありません。

自分ではコードを書かなかった私が、必要な道具を作る工程に参加できました。 長い物語を作るために、複数のAIエージェントと原稿を受け渡すこともできるようになりました。 できることが増えた実感があります。

AIが文章やプログラムを作ることは、これから当たり前になっていくと思います。 その変化を受け入れ、AIに何を任せ、自分はどこに関わるのかを、暮らしや仕事の中で考えていきたいのです。

すべての工程を自分の手で行わなくてもいい。 途中の成果物をすべて読む必要も、仕事によってはないでしょう。 そのうえで、出来上がったものを誰が使うのか。実際に役に立っているのか。 問題が起きたときに、どこへ戻ればよいのか。

制作を速く進める仕組みと、その成果を実際に使って確かめる機会を、両方持っておきたいと思います。

経営に置き換えると

人がすべての成果物を確認することを前提にすると、AIが作る速度に確認が追いつかなくなるかもしれません。 そこで必要になるのは、業務ごとに、人が判断する場所を具体的に決めることだと思います。

社内で比較するための案なのか。顧客へそのまま送る文章なのか。 実行すれば権限や契約条件が変わる処理なのか。 同じ「AIが作ったもの」でも、確かめるべきことは違います。

今回の管理ツールでも、まず新しい会員一人の利用準備に範囲を絞りました。 実際に試し、運営が楽になるかを確かめるところから始めました。

任せる範囲を決め、結果を確かめ、その結果に応じて範囲を変える。 この判断まで含めて、AIと働く環境を作ることなのだと思います。

最後に残したい時間

第2回は、 「AIに長編小説を書かせ続けるために、設定ファイルを16個に分けた話」 でした。

その設定の置き場を今回あらためて数えると、直下に24ファイルと、 調査記録と作中の観測値を収める2つのフォルダがありました。 24ファイルの内訳は、番号の付いた22ファイルと、人物の確認用ファイル、文体の憲法です。 フォルダ内の記録は、この数には含めていません。

第2回のタイトルに置いた数字は、制作を続ける間に変わりました。

ファイルが増えたから、質が上がったとは言えません。 調査記録がそろっていても、原典の確認が足りていないことはありました。 書き残すべきことや、確かめるべきことが変わり、そのたびに構成を見直してきた結果です。

この連載では、設定ファイルの質を、別の日の自分と、担当の違うAIが、 同じ判断に行き着けることとして考えてきました。

作品の目的、人物の願い、文体、時系列。 それらを書き残し、AIエージェントが使える手順に組み込みました。 評価の観点を分け、指摘を改稿へ戻す流れも作りました。

その仕組みは、これからも変わるでしょう。 任せられることが増えれば、今は私が行っている確認を、AIに任せることもあると思います。

それでも、小説を読む時間は残したい。

AIエージェントが原稿を作る速さに、私が読んで考える速さは追いつきません。 でも、自分が読んで面白いと思うことも、私が小説を書く理由だからです。

サイト制作で感じた「文明の夜明け」は、ものを作る工程が、 自分の知っている速さを超えて動き始めた実感でした。 小説制作では、その速さの中で、自分が残したい時間に気づきました。

設定ファイルも、ハーネスも、評価と改稿のループも、AIに任せるために作りました。 その仕組みが動くようになったことで、今度は、自分がどこに関わりたいのかが見えてきました。

すべてを自分で作ることにこだわらなくなっても、 自分が何に価値を感じるのかは、問い続けていたいと思います。

「自分はどこに関わりたいか」という問いには、対応する一つの設定ファイルはありません。 仕組みを使いながら、私自身が考え続けることです。

前回: AIに小説を書いてもらう手順を設計する — ハーネスと、書き直すループ

次回: 全8回の連載は、今回で終わりです。
2026-09-16 00:00:00

AIに小説を書いてもらう手順を設計する — ハーネスと、書き直すループ

AIと小説をつくる仕組み・全8回 第7回

――設定を誰に、どの条件で使わせ、評価後にどう改稿するか

AIに小説を書いてもらう手順を設計する — ハーネスと、書き直すループ

AIと小説をつくる仕組みを紹介する、全8回連載の第7回です。

前回の 「時系列と確定事実 — 矛盾はここで起きる」 では、過去の出来事を記録し、次の場面と照合する工夫を紹介しました。 今回は、それらをどう組み合わせてAIに使ってもらうかという話です。

これまで、作品の目的、文体、人物、タイムライン、用語集について書いてきました。 ほかにも、各回で何を描くかを決めた場面設計があります。

必要な設定をそろえても、AIが適切に参照し、作品に反映するとは限りません。 何を読んでから書くのか。設定が食い違ったら何を優先するのか。 書いた本文を誰が確かめ、どこへ戻して直すのか。 その手順も設計する必要があります。

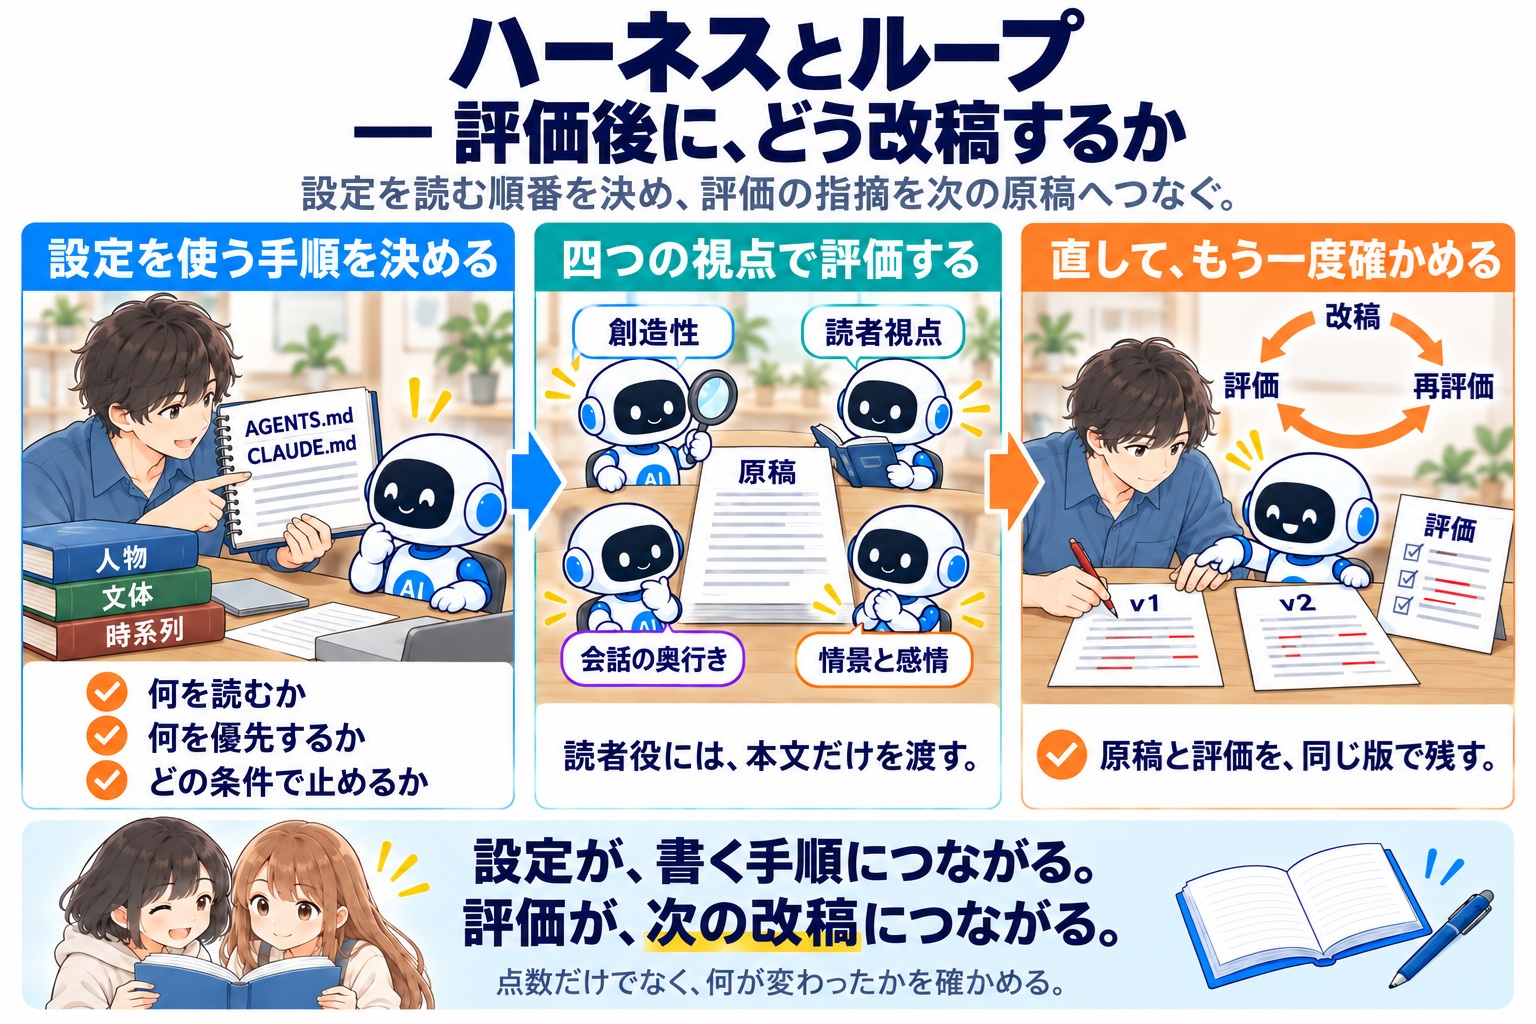
第1回「AIが働く環境をつくった一年」 では、AIと制作する仕組みを四つの層で整理しました。 今回は、そのうちの「Harness Engineering — AIが働く『環境』を設計する」と 「Loop Engineering — 生成・評価・修正の『反復』を設計する」を、実際の執筆工程から紹介します。 以下では、それぞれを短く「ハーネス」「ループ」と呼びます。

これまで整えてきた設定ファイルを、どの担当AIエージェントに、どの条件で使わせるか。 そして、評価で見つかった問題を、どう次の改稿へ戻すか。 問い50までの制作記録をもとに、そのつながりを見ていきます。

1.設定ファイルを、執筆の手順につなぐ

「何を渡すか」の次に、「どう使うか」を決める

人物設定には、その人が何を願っているかを書きます。 タイムラインには、いつ何が起きたかを残します。 場面設計には、その回で起こす出来事や、中心となる場面を記します。

それぞれ役割が違うので、AIにまとめて渡すだけでは、どの情報を何の判断に使うかが曖昧になります。

そこで、執筆担当AIエージェントには、その回に関係する設定を読み直してから書くよう指示しています。

日付や小道具の状態は、以前のチャットで伝えたから覚えているはず、と考えず、 執筆のたびに設定ファイルを読み直して確認させます。

読む順序と、判断の優先順位も分けて考えます。 後から読んだファイルが、そのまま優先されるわけではありません。 記述が食い違った場合は、あらかじめ定めた優先順位へ戻ります。

何を読むかに加えて、読んだ情報をどう扱うかまで決める。
これが、小説を書くためのハーネスの中心です。

入口になる二つのファイル

この運用を記述しているのが、AGENTS.mdとCLAUDE.mdです。

制作を始めるときの入口として、依頼の受け取り方、執筆から評価へ進む手順、保存方法、 改稿や承認の扱いを伝えます。 ファイル自体がプログラムを実行するのではなく、AIが作業するときに従う指示書です。

二つのファイルは、使う環境に応じて参照される入口として用意し、同じ運用内容を保つ方針にしています。

たとえば、AGENTS.mdには、次のような依頼の読み分けがあります。

私が入力すること AIに行わせること
Q44を書いてください 執筆し、各担当AIエージェントが評価し、結果を統合する
Q44を本文だけ書いてください 本文の執筆だけを行う
Q44を書き直してください 最新稿と評価レポートを読み、改稿して再評価する
Q44を承認してください 確定稿を保存し、タイムラインと用語集を更新する

「書いてください」という短い依頼の後ろに、必要な作業をあらかじめ置いておきます。 毎回、同じ長い指示をチャットに書かなくても、何をどこまで行うかが決まります。

場面設計を、均等に文章化しない

場面設計に書かれたことを、順番にすべて文章にすれば小説になるわけではありません。

そこで、執筆担当AIエージェントには、本文を書く前に、必ず入れる出来事、表現の候補、禁止事項、 核となる場面、短く処理する場面、分量を取り出すよう指示しています。

必ず入れる出来事と、使ってもよい表現の候補を分ける。 中心となる場面に分量を寄せる。すべての出来事を同じ長さで並べない。

問い50では、二人が答案を広げ、一緒に分からない問題を調べる場面を書きました。 その後、勉強の場面を約250字短くした版を作っています。

再評価では、会話の奥行きを見る担当AIエージェントが、短くしても 「二人とも分からない問題を一緒に調べる」という場面の働きは保たれていると確認しました。

大切なのは、勉強の手順を残らず書くことではありません。 片方が教え、片方が教わるだけの関係にならず、二人が一緒に取り組んでいることです。

こうした場面の核を、執筆時にも改稿時にも確かめられるようにします。

2.四つの視点で読み、それぞれの問題を見つける

同じ本文を、違う観点から読む

本文ができたら、執筆担当AIエージェントの自己確認を経て、評価へ進みます。

問い50までの基本となる評価は、四つの観点に分けています。それぞれに別の指示文があります。

担当AIエージェント 主に見ること
創造性の担当AIエージェント 人物が動いているか、場面に引っかかりや余白があるか
読者視点の担当AIエージェント 本文だけで理解でき、続きを読みたくなるか
会話の奥行きの担当AIエージェント 本音と建前のずれや、言わないことが働いているか
情景と感情の担当AIエージェント 場所や身体の描写から、感情を受け取れるか

実際に問い50のv3では、評価する場所が分かれました。

読者視点の担当AIエージェントは、前の回を読んでいないと一瞬分かりにくい言い回しを指摘しています。 一方、情景と感情の担当AIエージェントは、6月という時期が日付の情報にとどまり、 湿度などの体感が弱いと指摘しました。

会話の奥行きの担当AIエージェントは、莉子が保管していた絵について言う 「捨てる理由ないし」という台詞を評価しています。 保管していた理由を説明せず、言葉の表面と、その下に読めるもののずれを残しているからです。

同じ原稿でも、読む入口が違えば、拾うものが変わります。 評価を分けることで、何を残し、何を検討するかが具体的になります。

読者役には、設定を渡さない

役割を分けるときには、渡す情報も変えています。

読者視点の担当AIエージェントには、設定ファイルや場面設計、ほかの評価レポートを渡しません。 今回の本文だけを読ませます。

設定を知っていれば、本文に書かれていない理由を補えてしまいます。 作者の意図を知っているから理解できたのか、本文だけで理解できたのかが分からなくなるためです。

問い50の評価で「前の回を読んでいないと分かりにくい」と指摘できることも、この読み方に意味がある理由です。 その指摘を受けて、説明を足すか、連続して読む作品として残すかを検討できます。

一方、整合性を確認する担当AIエージェントには、設定と確定稿を読み直させます。

問い50には、莉子の「真帆方式」に、ルミが「真帆さん方式」と返す短いやり取りがあります。 会話としては、姉を呼ぶ妹と、憧れている相手を呼ぶルミの違いが出ています。

同時に、整合性の確認では、ルミがすでにその名前を知っているかを確かめる必要があります。 問い47で命名が成立しているため、問い50で使える呼び名です。

言葉の面白さを読むことと、その言葉を使える時点かを確かめること。
両方が必要なので、担当AIエージェントと渡す情報を分けています。

複数の指摘を、改稿する箇所へまとめる

問い44の初稿では、ルミが不満をぶつける長い台詞に、複数の担当AIエージェントが注目しました。

創造性、読者視点、会話の奥行きの評価が共通して指摘したのは、 不満が経緯どおりに並び、報告のように整いすぎていることでした。

整合性の担当AIエージェントは、同じ台詞の「仕事くださいって」という言い方が、 問い42での実際の発言と少し違うことを指摘しています。

統合担当AIエージェントは、これらを同じ箇所の改善提案としてまとめました。

次の版では、台詞が途中で切れる形になっています。

「お姉さんも。弟子にしてって言ったら、募集してないって。お父さんは、信じるんだ、って。信じて、どう――」

再評価では、長台詞の整いすぎと、過去の発言との微差が解消されたことを確認しています。

「もっと自然な会話にする」という依頼だけでは、何を変えるかが曖昧です。 誰がどこを問題にしたかをまとめ、次の原稿で直す箇所へつなげます。

3.評価を、次の改稿へ戻す

ループの指示は、どこにあるのか

評価が終わると、統合担当AIエージェントが各レポートを読み、総合点と改善提案をまとめます。 その指示文が、99_integrated_analyzer.txtです。

点数の計算方法だけでなく、優先して直す箇所、修正の大きさ、次にどの評価を行うかも定めています。

一方、改稿を依頼されたときに、どの原稿とレポートを読み、どこまで実行するかは、 AGENTS.mdとCLAUDE.mdに書いてあります。

ループは、一つの専用ファイルにまとまっているわけではありません。 運用ファイルが改稿の進め方を定め、統合担当AIエージェントの指示文が評価結果を次の修正へつなぎます。

設定を確認する → 本文を書く → 各担当AIエージェントが評価する
→ 結果を統合する → 改稿を依頼する → 次の版を書き、再評価する

現行の基本コマンドでは、「書き直してください」と依頼すると、改善提案を反映し、評価と統合まで一巡します。 「優先度1だけ反映してください」と指定した場合は、その範囲を直し、再評価は明示して頼む扱いです。

どこを直すか、どこまで評価を回すかを指定できるようにしています。

原稿と評価を、同じ版で残す

ループを回すには、評価がどの原稿に対するものかを間違えないことも必要です。

原稿はq44_v1.md、次の版はq44_v2.mdというように保存し、 評価レポートにも同じ版番号を付けます。原稿は上書きしません。

問い44では、長台詞の問題が解消された後のv2でも、別の指摘が残っていました。

理由になっているような、なっていないような答えだった。

この一文を、読者より先に地の文が答えを採点していると最初に指摘したのは、v2の評価です。 v4でも指摘され、確定稿で削除しました。

版を残していれば、何がいつ指摘され、いつ直ったかを確かめられます。 「評価されて直した」という一つの話にまとめず、 どの原稿に対する評価だったかをたどれるようにしています。

点数は、改稿の良し悪しを一つで表せない

総合点は、原稿の状態を確認する目安になります。承認基準の一つは85点以上です。 ただし、必要な評価がそろい、重大な矛盾や規則違反がないことなど、ほかの条件も満たす必要があります。

問い50では、勉強の場面を約250字短くしたところ、総合点はv2の90点からv3の88点になりました。

一方、v3のレポートでは、創造性と情景の担当AIエージェントが、中盤のもたつきが解消したと評価しています。 会話の奥行きの担当AIエージェントも、二人が一緒に取り組む場面の働きが保たれたと確認しました。

レポートには、評価が別のセッションで行われたため、数点の揺れを含むという注記もあります。 この記録から、短くしたことが点数を下げた原因だとは言えません。

点数だけなら、前の版へ戻したくなるかもしれません。 しかし、何を直そうとして、本文がどう変わり、各評価が何を確認したかまで読むと、判断する材料は変わります。

問い44でも、総合88点の稿に残っていた地の文の指摘三箇所に対し、 確定稿では二つを削除し、一つを残しています。

ループの目的は、評価の指摘をすべて消すことではありません。
作品に必要な表現を残しながら、問題を直すことです。

止める条件と、次へ渡す条件を決める

整合性を確認する担当AIエージェントが重大な矛盾を見つけた場合は、 ほかの評価が高くても承認不可にします。 面白さの点数で、事実の食い違いを埋め合わせないためです。

後半の制作では、本文の現実性を見る担当AIエージェントと、 執筆前に調査記録の根拠の確かめ方を検査する担当AIエージェントも加えました。 進める手順と同じように、止める条件も必要になったからです。

そして、承認するときには、本文を確定するだけでなく、次の回へ渡す記録も更新します。

問い47では、莉子からのLINEで『真帆』という名前が伝わります。 それまで「お姉さん」だった人の名前を、ルミが知る場面です。

評価レポートは、本文を承認できる水準としつつ、命名などを設定へ反映する必要も挙げています。 用語集には、問い47で名前が伝わったことが記録されています。 その記録が、問い50の「真帆さん方式」という台詞を支えます。

今回の本文で起きたことが、次の回の前提になる。 前回紹介した記録の仕組みも、ここで執筆の流れにつながります。

経営に置き換えると

業務でも、AIに資料を渡して「提案書を作って」と頼むだけでは、 何を根拠に書き、誰に確認してもらうかが曖昧になります。

提案書なら、顧客の要望、社内の商品情報、承認済みの価格を参照させる。 作成後は、顧客に伝わるかを読む担当AIエージェントと、価格や提供条件を照合する担当AIエージェントを分ける。 未承認の条件が含まれていたら、提出前に止める。こうした手順が、ハーネスにあたります。

確認で見つかった問題をまとめ、修正した版を作り、直した箇所を再確認する。その反復がループです。 提案書と確認結果に同じ版番号を付けておけば、 古い価格を直したのか、前の版への指摘が残っているだけなのかも区別できます。

小説の制作で設計してきたのも、同じことです。 何を参照するか、何を確かめるか、どの条件で止めるか、修正をどこへ戻すか。 AIに任せる仕事を、この単位まで具体的にしておきます。

設定ファイルに、作品の判断基準を書く。 ハーネスで、その基準を誰がどの場面で使うかを決める。 ループで、評価を本文の修正へ戻す。

小説を書くうえで私が大切だと感じているのは、このつながりです。 設定を詳しく書くだけでなく、その設定が執筆と評価のどこで働くかまで設計しておきます。

次回は、全8回の最終回です。 仕組みが動くようになったあとに残った、私自身の時間について考えます。

関連する運用ファイルと指示文

AGENTS.md/CLAUDE.md

制作の入口となる運用指示です。 依頼の解釈、執筆・評価・改稿の流れ、版の保存、承認、失敗時に止める条件を定めます。

00_priority.md

設定が食い違った場合に、どの指定を優先するかを定めます。

1_writer_agent_extended_v2.txt

執筆担当AIエージェントへの指示文です。 執筆前に参照する設定、場面設計から取り出す項目、本文を出す前の確認などを定めます。

2_creative_evaluator.txt/3_reader_validator.txt/4_dialogue_complexity_evaluator.txt/5_landscape_emotion_evaluator.txt

基本となる四つの評価担当AIエージェントの指示文です。観点と、必要な入力を分けています。

7_consistency_validator.txt/8_simulation_reality_evaluator.txt/9_research_integrity_validator.txt

それぞれ、設定と本文の整合性、本文の現実性、執筆前の調査記録の根拠の確かめ方を検査します。

99_integrated_analyzer.txt

評価を統合し、総合点、優先度別の改善提案、合否判定、再評価の対象をまとめるための指示文です。

2026-09-13 23:33:00

時系列と確定事実 — 矛盾はここで起きる

AIと小説をつくる仕組み・全8回 第6回

――100回書き継ぐために、何を記録し、書く前にどこへ戻るか

時系列と確定事実 — 矛盾はここで起きる

AIと小説をつくる仕組みを紹介する、全8回連載の第6回です。

前回の 「人物をぶらさない仕組み — キャラクターは、何を願っているのか」 では、人物の願いや家族関係を設定に書き込み、同じ人物から考え始める仕組みを紹介しました。 今回は、その人物が生きている時間と、すでに起きた出来事の話です。

AIは、物語のどの時点の場面でも書くことができます。 ただし、生成された場面が、それまでの時間の流れに合っているとは限りません。 前の回から何日たったのか、持っていた物は誰に渡したのか。 そうした事実を引き継がなければ、続けて読んだときに食い違いが出てきます。

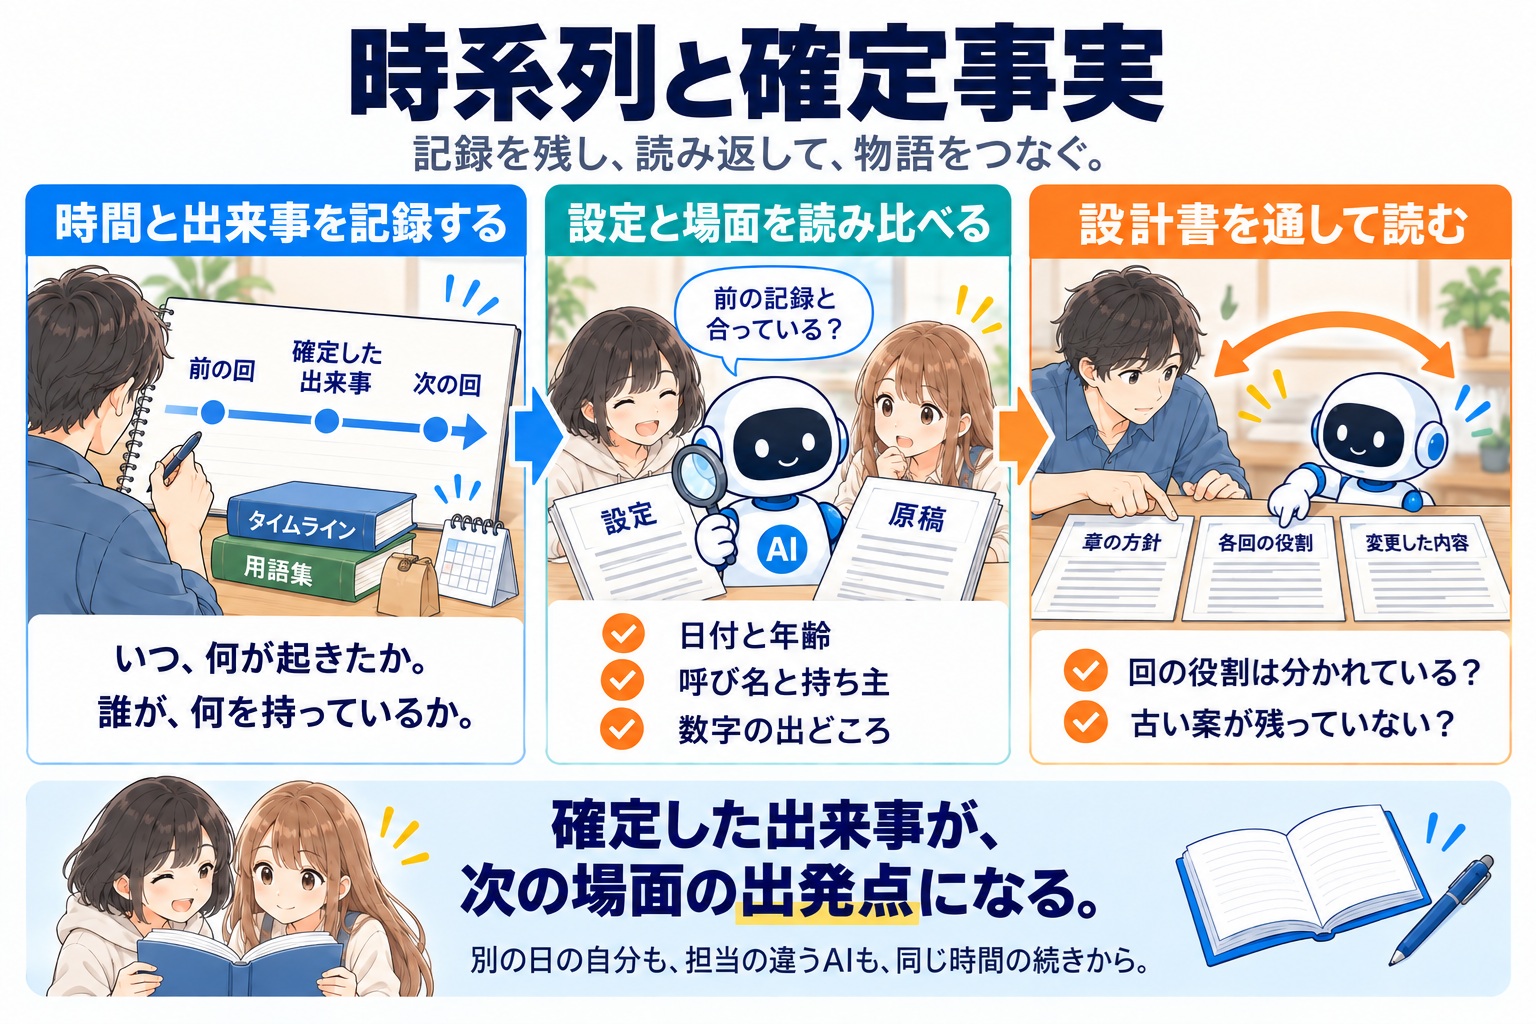
そこで、先に物語の時間軸をタイムライン、つまり年表として設定しておきます。 物語を書き進めるたびに、いつ、何が起きたのか、確定した事実を書き残します。 次のシーンを書くときには、その記録を見て、前の出来事から何日たったのか、 その間に何があったのかを確かめます。

100回にわたる物語の続きを書くには、登場人物がそれまでに経験したことを引き継ぐ必要があります。 タイムラインは、そのための設定ファイルです。

それでも、記録を用意するだけでは矛盾を防ぎきれません。 今回は、実際に起きた食い違いをたどりながら、確認が抜けやすいところと、それを確かめる工夫を紹介します。

1.タイムラインに、人物が経験したことを残す

時間の流れと、確定した出来事を分ける

最初に決めるのは、物語全体の時間の流れです。 何年生の、どの季節から始めるのか。次の章までに、どのくらい時間がたつのか。 まず、その見通しを置きます。

ただし、これから書く予定と、すでに本文で起きた出来事は同じではありません。 予定は設計として持ち、書き終えて承認した出来事を、確定した記録として残します。

タイムラインには、各回の学年、季節、経過時間と、その回に何が起きたかを記録します。 次を書くときは、最後に確定した出来事から続きを考えます。

日付だけでなく、人物の記憶を引き継ぐ

この作品では、タイムラインと合わせて、用語集も使っています。

記録先 確かめたいこと 記録する内容
タイムライン いつ、何が起きたか 学年、季節、経過時間、確定した出来事
用語集 日付や呼び名、物の状態はどうなっているか 誕生日、数字、呼称、小道具の状態と根拠

用語集という名前ですが、言葉の意味だけを集めているわけではありません。 次の回を書くときに、記憶や推測で補ってはいけない事実を置いています。

たとえば、ルミの誕生日は4月22日です。 用語集には日付と初出の回を、タイムラインには、その誕生日に何が起きたかを記録します。

次の回を書くときには、年齢だけでなく、ルミがその日に何を経験したかも確認できます。 誕生日の出来事を、ルミ自身の記憶として、その後の会話や行動につなげていくためです。

小道具にも履歴が必要です。 問い44に登場する莉子の紙袋は、用語集に「渡されないまま莉子が持ち帰った」と記録されています。

紙袋が登場したことだけを覚えていても、その後の場面は書けません。 誰が持っているのかまで確かめる必要があります。 この記録があれば、ルミが受け取ったことにして続きを書くのを防ぐ基準になります。

承認した内容を、記録へ戻す

草稿は、改稿によって変わります。 そのため、草稿に書いたことをすぐに確定事実として登録すると、 最終的な本文と記録が食い違うおそれがあります。

そこで、原稿の承認時に、確定稿の保存とタイムライン・用語集の更新を一組で行う運用にしています。

問い44の紙袋についても、次の回へ引き継ぐのは、確定稿に基づく「渡されず、莉子が持ち帰った」という状態です。 書く途中で考えた可能性と、本文で確定した出来事を混ぜないようにします。

次を書く人やAIが参照する場所まで更新して、承認の処理が終わります。

2.記録した数字や設定と、次の場面を照合する

数字にも、出どころがある

日付や出来事に加えて、数字も引き継ぐ必要があります。

問い51からの後半では、二人が事業に取り組む中で、価格や数量、作業時間など、さまざまな数字を扱います。 調べた数字なのか、試算のために仮に置いた数字なのかを区別するため、数字を四種類に分けました。

種類 何を表すか 確認する根拠
外部調査値 外から調べた価格や制度上の数値 出典、確認日、適用条件
仮定値 試算の入力や実験の目標 誰が、どんな条件で仮に置いたか
作中の観測値 物語の中で作った数、売れた数、かかった時間 本文の場面や作中の記録
既存設定値 年齢や日付など、すでに決めてある値 設定の正本と確定稿

販売個数なら、試算のために置いた個数と、物語の中で実際に売れた個数を区別します。 どちらも単価を掛ければ売上を計算できますが、前者は売上の見込み、後者は作中の販売結果です。

仮に置いた個数を、売れた個数として引き継いではいけません。 記録には、「試算のための仮定」なのか「作中で売れた結果」なのかも残します。

確認する先も違います。 外から調べた価格なら出典へ戻り、作中の販売個数なら、その販売を描いた本文へ戻ります。 ルミの誕生日なら、用語集を確認します。

また、作中の販売結果を、現実の事業の実績として記事や教材で紹介しないことも決めています。 数字の出どころは、執筆中だけでなく、作品の外で説明するときにも必要です。

経営に置き換えると

試算のために置いた数字と、実際に出た数字は、資料の上では同じ形をしています。 区別して記録しておかないと、見込みが次の資料では実績として引き継がれます。 数字を残すときに、それがどこから来た値かも一緒に残す。 AIに資料を作ってもらうときほど、この区別は人が決めておく必要があります。

学校の設定と、進路の話題が合わなかった

記録があっても、それを場面と読み比べなければ、食い違いは見つかりません。

第2回「AIに長編小説を書かせ続けるために、設定ファイルを16個に分けた話」 では、学校の設定と、場面で使った進路の話題が合わなかった見逃しを紹介しました。

二人の学校は、中高一貫校という設定です。高校受験はありません。 ところが、教室の会話だけを読んでいると、学校の前提に合わない進路の話題でも、 中学生の会話として通ってしまいます。

「中学生なら、こういう話をするだろう」という感覚だけでは、 この学校に通う二人の会話として合っているかを確かめられません。

必要なのは、次の順序で読むことです。

  1. その場面で、二人は何年生なのか。
  2. どのような学校に通っているのか。
  3. その学校の、その学年で、場面の進路の話題が成立するか。

いまの設定には、高校受験がないことに加えて、 コース分け、学年順位、模試、塾、その先の大学が進路の話題になることも記しています。

学校の前提を確かめると、将来への焦りを描くときにも、どの話題を使えるかが具体的になります。

当時の確認担当が何をどこまで読んだかは、記録なしに断定できません。 ただ、防ぐために必要な工程は示せます。 設定を読むだけで終わらず、そこに書かれた条件と、実際の台詞を読み比べること です。

食い違ったら、どちらを正とするか

読み比べると、設定ファイル同士で、適用する時期の違う指定が見つかることもあります。

前回紹介したルミの身体の癖が、その一例です。 初期の人物設定には、考えるときに親指の爪を撫でる癖があります。 一方、後の指定では、問い41以降は使わないと決めています。

初期設定にあるからといって、問い41以降の場面で再び使ってよいわけではありません。 対象となる回に適用される指定を優先します。

その判断を毎回やり直さなくてよいように、設定の優先順位をあらかじめ決めています。 優先順位を確認しても判断できない場合は、推測でつなげず、確認が必要な箇所として止めます。

ここまでは、書いている場面を、その外にある記録と照合する話です。 ところが、同じ設計書の中で、回の役割や内容が食い違う場合もあります。

3.書き直したら、設計書全体を読み直す

一日で、三つの食い違いが見つかった

ある章の設計を、版を重ねて直していたときのことです。 通し読みをすると、一日で三つの食い違いが見つかりました。

見つかったもの 食い違いの内容
章の役割 次章へ移したはずの役割を、先取りする回が残っていた
回の分担 一つの回に、作る工程と渡す工程が同居していた
旧設定 外したはずの設定が、別の箇所に残っていた

一つの回に作る場面と渡す場面が両方あると、その回だけでは成立していても、 次の回へ何を残すかが曖昧になります。

このときの修正では、渡す場面をその回に残し、製造の場面を次の回へ移しました。 作中で製造せずに渡したという指摘ではなく、どの工程をどの回で描くかという分担の修正です。

必要な場面がそろっていることと、
回ごとの役割が分かれていることは違う。

最新のファイルの中に、古い案が残る

設計を変更するときには、まず変更の中心となる箇所を直します。 章の目的を変える。ある工程を別の回へ移す。使わない設定を外す。

しかし、変更した内容が、別の回の説明や、章全体のまとめにも書かれていることがあります。

今回も、章の役割を変更した一方で、個々の回には以前の役割を担う記述が残っていました。 冒頭の方針を直すだけでは、各回の中身までそろったことにはなりません。

版を重ねるほど、同じ文書の中に、異なる時点の判断が混ざる可能性があります。 最新のファイルを使っていても、その中に古い案が残っていることがあります。

この種類の食い違いは、ファイル同士の優先順位だけでは解けません。 同じ設計書の冒頭と後半で話が違っているなら、その設計書を最初から読み直す必要があります。

二種類の矛盾を、別々に確かめる

制作を続ける中で、矛盾には二種類あると考えるようになりました。

ひとつは、書いている場面が、別のファイルにある設定や確定済みの出来事と食い違うこと。 学校の前提と進路の話題が合わなかった件が、これにあたります。

もうひとつは、同じ設計書の前半と後半で、回の役割や内容が食い違うこと。 一つの回に二つの工程が入っていた件や、外したはずの旧設定が残った件が、こちらです。

矛盾の種類 確かめ方
別の設定や確定稿との不一致 関係する記録まで戻り、場面と読み比べる
同じ設計書の中の不一致 全体を読み直し、回の役割や古い案の残りを確かめる

用語集に紙袋の持ち主を記録していても、次の回を書く前に確認しなければ、その状態を引き継げません。 設計書を最新版にしても、次章へ移したはずの役割が別の回に残っていれば、そのまま本文になるかもしれません。

記録を残すことと、その記録を使って確かめること。 この二つを一緒に決めておく必要があります。

いつ、何が起きたのか。
そこまでに、何が決まっているのか。
続きを書く前に、同じ記録へ戻る。

別の日の自分も、担当の違うAIも、その時間の続きから書き始められるようにしています。

次回は「AIに小説を書いてもらう手順を設計する — ハーネスと、書き直すループ」。 設定ファイルを執筆の手順につなぎ、四つの視点で評価し、その結果を次の改稿へ戻すまでを扱います。

関連する設定ファイル

10_timeline.md

各回の時期、季節、経過時間、確定した出来事を記録します。 次の回を書く前に、時間のつながりと、人物がそれまでに経験したことを確認するためのファイルです。

12_glossary.md

日付、数字、呼称、小道具の状態など、継続して参照する確定事実と根拠を管理します。 原稿の承認時に、タイムラインと合わせて更新します。

00_priority.md

設定同士が食い違った場合の優先順位と、新旧の指定の扱いを定めます。

14_simulation_phase_q51_100.md

後半の執筆規約を定めるファイルです。 この記事で紹介した数字の四分類と、種類ごとの根拠の確かめ方も記しています。

これらのファイルを記事や教材に使う際には、公開区分に従って、予定や非公開情報を除いた内容を扱います。

2026-09-10 23:23:00

人物をぶらさない仕組み — キャラクターは、何を願っているのか

AIと小説をつくる仕組み・全8回 第5回

――100回書いても同じ人物でいるために、何を決めておくか

人物をぶらさない仕組み — キャラクターは、何を願っているのか

AIと小説をつくる仕組みを紹介する、全8回連載の第5回です。

前回の 「文体を『憲法』にする — 自分の文章を分解し、直した理由をルールへ戻す」 では、文章の書き方を、判断できる規則にする話をしました。 今回は、その文章の中で生きる人物をどうつくるかです。

『13歳、わたしはお金持ちになると決めた。100の問い』には、ルミと莉子という二人の主人公がいます。 100回にわたって二人を書いていくには、書く日や担当するAI(モデル)が変わっても、 その人物の行動を選ぶ根拠が必要になります。

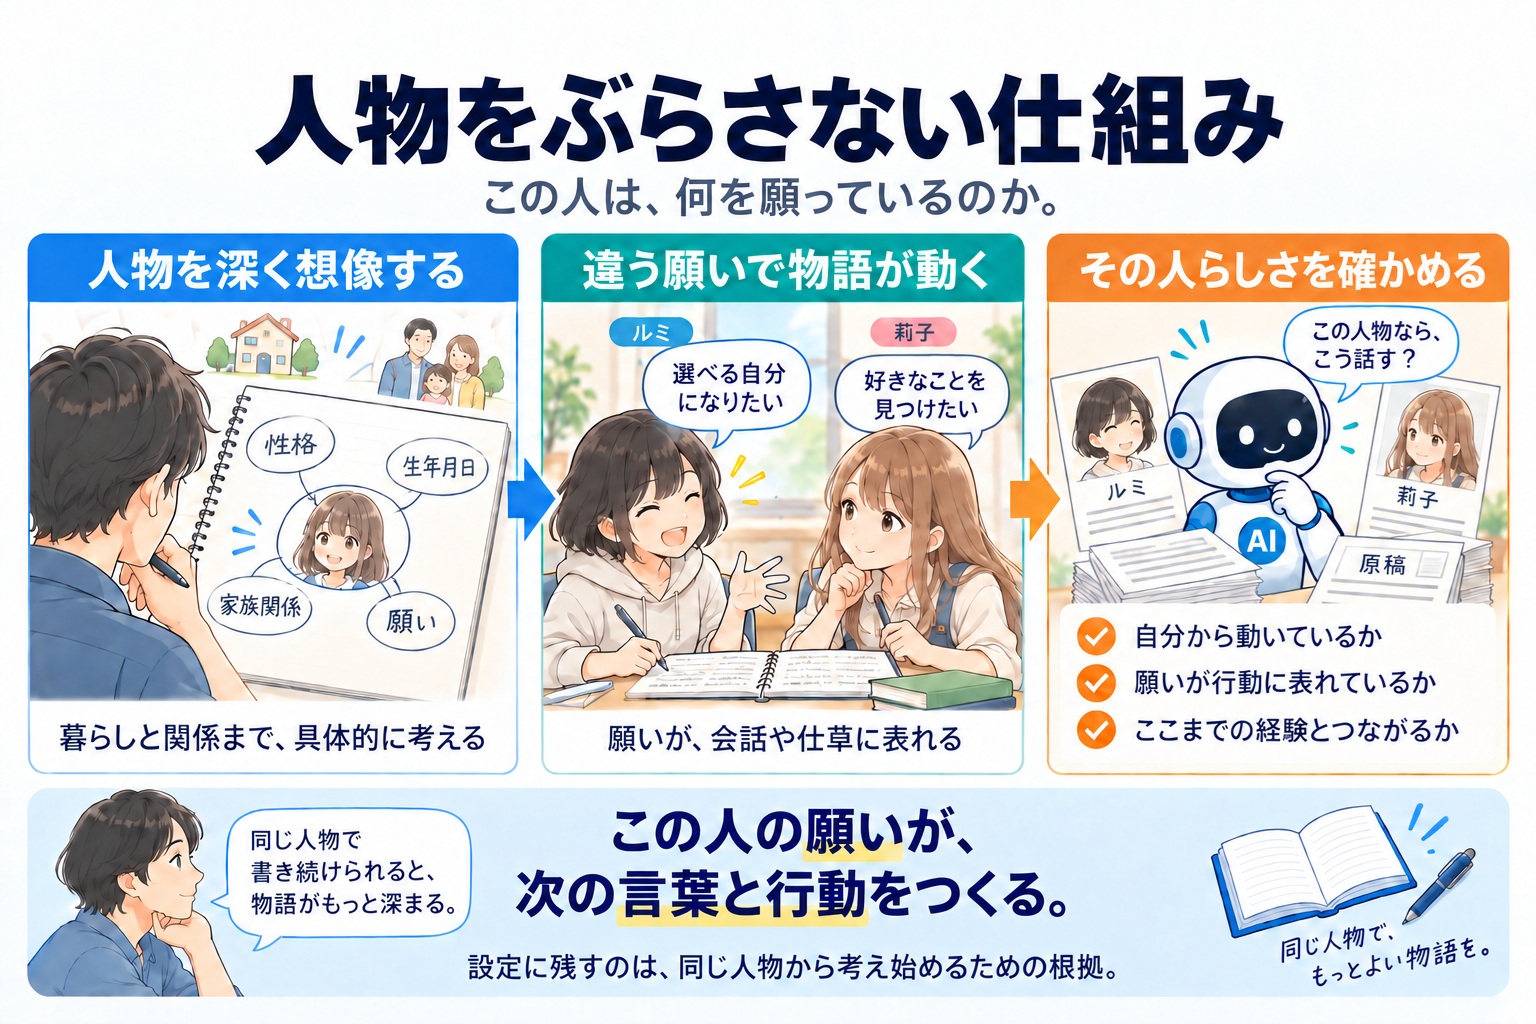
私が中心に置いているのは、「キャラクターは、何を願っているのか」という問いです。 その願いを持つ人間を、とことん具体的に想像するところから、キャラクターの設定を始めています。

1.人物を、暮らしと関係からつくる

マインドマップで、人物の輪郭を広げる

キャラクターを考えるときには、マインドマップを使うこともあります。 ひとりの人物を中心に置いて、性格や家族関係、関心のあるものなどを広げながら、 その人の輪郭を探っていきます。生年月日も合わせて考えます。

設定を考えている段階では、本文に出すかどうかだけで情報を絞りません。 どんな毎日を過ごしてきたのか。何を見て育ち、何を当たり前だと思っているのか。 実際にそこにいる主人公たちを想像できるところまで、書き込んでいきます。

人物設定には、「見ているもの」「考えていること・感じていること」「痛み・不安」などの項目があります。 性格を表す言葉に加えて、その性格がどんな場面で、どんな反応として現れるかを考えるためです。

子供の人物像は、家族と一緒に考える

ルミと莉子は、家族との関係の中で育ってきた子供です。 二人の性格を考えるときには、両親や姉妹(きょうだい)との関係も合わせて考えます。

たとえば、ルミは一人っ子で、莉子には10歳上の姉がいます。 同じ「莉子の姉」に会っても、二人にとっての意味は違います。 ルミには憧れの対象でも、莉子にはずっと同じ家庭で暮らしてきた相手です。

この関係の違いがあれば、同じ言葉を聞いたときの反応も変わります。 人物を単独で細かく設定することに加えて、 誰の前にいるとき、どんな自分になるのか を考えておきます。

一方で、両親には名前をつけず、「父」「母」として物語を進める試みもしています。

両親は重要な登場人物です。 ただ、大人たちの存在が大きくなりすぎると、主人公たちがかすんでしまうことがあります。 家族の人物像は考えながら、読者の目が二人へ戻るように、本文での見せ方を選んでいます。

2.違う願いを持つ二人で、物語を動かす

名前を変えただけの二人にしない

同じ性格で、同じことを考える人を二人並べても、掛け合いは動きにくくなります。 そこで、ルミと莉子は、できるだけ正反対に近い人物として考えました。

出発点から、二人は違います。

人物 出発点 抱えている不安
ルミ お金があれば、遠慮しなくていい 自分は選べているのか
莉子 好きなことがわからない 選択肢が多すぎて、決められない不安

ルミには、手に入れたいものがあります。 莉子は、選択肢があっても、自分が何を選びたいのかを決められずにいます。 この違いを持つ二人が、一緒に何かを始める。 同じ出来事を見ても、先に気になることや、口にする言葉が違ってきます。

その掛け合いや重なりの中で、物語を動かしていくことにしました。

ただし、何もかも反対にすればよいわけではありません。 二人が一緒にいようとする理由も必要です。 違う人間が、どこで相手に惹かれ、どこで噛み合わなくなるのか。 その関係まで考えて、二人を置きます。

願いを、会話と仕草の根に置く

人物を人間らしくするうえで、私がいちばん大切にしているのは、願いを持ってもらうことです。

この人は、一体何を願っているのか。 その願いがあるから、相手に声をかける。言わなくてもよいことを言う。手を伸ばす。逆に、口を閉じる。 会話や仕草の根に、本人が求めているものがあると考えています。

実際の設定には、ルミが店のメニューを開いたとき、右側の数字を先に見るという描写があります。 「お金があれば、遠慮しなくていい」という出発点が、視線の動きに現れています。

願いの内容を、毎回読者に説明する必要はありません。 その人が何を見て、どう動くかに表れていればよい。 書く側では願いを確認しながら、読む側には行動を渡します。

また、人物には、自分でも見えていないことがあります。 設定を知っているAIが、本人より先に理解の整った台詞を書いてしまうと、その人物から離れてしまいます。 そこで、人物ごとに、まだ気づかせないことや、させないことも定めています。

前回扱った「書かないほうの基準」が、ここでは一人ひとりの人物に結びつきます。

3.書いたあとに、その人らしさを確かめる

確認役に、願いと行動を見てもらう

人物設定を書いたら、それを渡して終わりにはしません。 できあがった物語でも、その人物らしさが保たれているかを確認します。 この確認役は、AIエージェントにも任せています。

確認用のファイルには、たとえば次の項目があります。

  • ルミは、この場面で自分から何かをするか。
  • 欲望と弱点が、場面の中にあるか。
  • 台詞・行動・身体の動きで個性が出ているか。
  • 前の回の自分と比べて、どこか変わっているか。

「ルミらしいか」という問いを、本文のどこを見れば判断できるかという形にしています。

人物をぶらさないことと、
人物を変化させないことは違う。

体験を重ねれば、できることも話し方も変わります。 その変化が、ここまで生きてきた本人につながっているかを確かめます。

設定と一致していても、その人物が言うとは限らない

第1回「AIが働く環境をつくった一年」 で紹介したキャラクターエージェントも、この確認に使いました。 AIに人物になりきってもらい、ストーリーや会話文を読んでもらう方法です。

ここで防ぎたかったのは、 設定とは矛盾しなくても、ストーリーを進める都合で本人に言わせてしまうこと です。

性格や知識に合う台詞でも、その相手に、その場で、その言い方をするとは限りません。 何を言うかに加えて、言いたいのか、隠したいのか、いま口にできるのかを考える必要があります。

そこで、設定との一致を見る確認に加えて、 「自分なら本当にこう話すだろうか」という立場でも読んでもらいました。 人物の願いと、その場の言葉のつながりを検討するためです。

この方法の効果を具体的に示すには、元の会話文、AIの指摘、採用した修正を並べて記録する必要があります。 ここでは、確認のために取り入れた方法として紹介しています。

変わったことにも、適用する時期を持たせる

人物を長く書くと、設定の扱いを変えることもあります。

ルミには、考えるときに親指の爪を撫でる癖がありました。 この描写は問い40までとし、問い41以降は使わないと決めています。 癖も、いつまでも繰り返す印にはしません。 使わなくなったことを記録しておかないと、AIが古い設定から再び持ち出してしまいます。

後半の人物像も、前半の項目を上書きせず、別の項目として加えています。 どの時期の人物を書くのかに応じて、参照する設定を変えます。

以前の人物像と、そこから変わった人物像。 その両方を残すことで、変化をたどれるようにしています。

4.詳しく設定することと、公開することを分ける

人物を深く想像するほど、設定には、その時点の読者へ渡せない情報も含まれます。 そこで、公開する範囲も運用として決めています。

ファイルごとに設けている区分は、次の三種類です。

区分 扱い
公開可 共通の確認を行い、公開用の写しを作る
要マスク 指定された範囲を伏せ、公開用の写しを作る
非公開 公開しない

この区分と、伏せる範囲や理由を管理する場所を決めています。 公開のたびに思いつきで判断せず、どこまで出せるかを確認できるようにするためです。 「公開可」であっても、確認なしに原本をそのまま出すという意味ではありません。

内部の原本を保持し、公開用の写しを作って内容を確認する。 記事や教材に編集する場合も、同じ基準を使います。

経営に置き換えると

社内で判断するために必要な情報と、社外に出す資料の情報は一致しません。 何を出せるか、その判断をどこに記録するか、誰が公開前に確認するか。 AIに資料を扱ってもらうときにも、この線引きは人が決めておく必要があります。

人物を詳しく設定することと、その設定をどこまで見せるかを決めることは、つながっています。 制作には必要でも、読者にはまだ渡さない情報がある。 その区別まで含めて、設定を管理しています。

とことん人物を想像すること。
その人の願いを確かめること。
そして、書かれた会話や行動に、その人がいるかを読み直すこと。

設定ファイルには、その判断の根拠を残していきます。 別の日の自分や、担当の違うAIにも、同じ人物から考え始めてもらうためです。

関連する設定ファイル

character_check.md

主人公の主体性、欲望と弱点、台詞や身体の動き、人物同士の関係、前の回からの変化を 確認するためのファイルです。 執筆前と講評時に参照し、気になる箇所を具体的な台詞や行動に即して検討します。

人物設定そのものは公開していません。 この記事では、設定を組み立てる考え方と確認の方法を紹介しました。

2026-09-07 22:30:00

文体を「憲法」にする — 自分の文章を分解し、直した理由をルールへ戻す

AIと小説をつくる仕組み・全8回 第4回

――「なんとなく違う」を、AIが判定できる形にする

文体を「憲法」にする — 自分の文章を分解し、直した理由をルールへ戻す

AIと小説をつくる仕組みを紹介する、全8回連載の第4回です。

前回の 「作品の目的と前提」 では、AIが作品世界に入るための入口を取り上げました。 今回は、その次に難しかった 「文体」 です。

AIに小説を書いてもらうとき、最後まで難しかったものの一つが「文体」でした。

内容については、比較的指示できます。

この場面では何が起きるのか。
誰と誰が話すのか。
主人公は何を見ているのか。
次の場面へ何を残すのか。

こうしたものは、設定ファイルやScene Planに書いておけば、AIもかなり理解してくれます。

ところが、
「どういう文章で書くのか」
となると、急に難しくなります。

文体をどうAIに渡すのか。
この1年間、かなり試行錯誤したところです。

1.自分の文を、数字にしてみた

まず、自分で文章を書いた

最初にやったのは、自分で気に入る文章を書くことでした。

自分が読んで、
「こういう文章が好きだ」
「この感じで小説を続けたい」
と思える文章を作り、それをAIに読み込ませました。

そして、その文章を分析してもらいました。

一文の長さ。
短い文と長い文の割合。
会話文と地の文の比率。
使われている言葉。
段落の長さ。
改行の仕方。
文章の流れ。

自分では「この文章が好き」としか言えなかったものを、AIに分解してもらったわけです。

その結果を、少しずつ設定ファイルに入れていきました。

現在の style_constitution.md には、たとえば一文の長さについて 平均21字、20字以下を半数、40字を超える文を6%以内 といった目安があります。地の文と会話にも比率の目安を置いています。

最初は、ここまで分析して数字にすれば、文体も再現できると思っていました。

ところが、そう簡単ではありませんでした。

条件は合っている。でも、読んでみると違う

AIに条件を渡して文章を書かせます。

一文は短い。
会話と地の文の比率も合っている。
指定したルールにも、ほぼ従っている。

それでも読んでみると、
「違うな」
と思うことがありました。

これは印象だけの話ではありません。評価レポートにも記録が残っています。 ある回の初稿につけた機械検査の結果です。

機械検査:本文3001字/数字表記・句点・『』・段落・()独白1回、すべて適合

機械的に確認できる項目は、全部通っています。 それでも同じ稿に対して、四つの評価担当がそろって同じ一箇所を指摘しました。

数字を満たしているかどうかと、読んで良いと思えるかどうかは、別のことでした。

特に多かったのが、文章が細かく切れすぎることでした。

一文。
一文。
一文。
というように、ブチブチと文章が切れてしまう。

確かに私は「短い文章」を好みます。

しかし、私が読みたかったのは、ただ短い文章を並べたものではありませんでした。

短い文がある。
少し長い文もある。
そこへ会話が入る。
地の文へ戻る。
少し間が空く。
また言葉が続く。

その流れの中に、文章の呼吸が生まれます。

文の長さを再現することと、文章のリズムを再現することは違う。

実際にAIと書いてみて、そこがよくわかりました。

たとえば、こんなところを直していた

実際によくやっていた修正を、単純化するとこんな感じです。

AIが出す文章が、

 教室の窓から風が入った。
 ルミはノートを閉じた。
 考えてみる。
 働くって、なんだろう。

となっていたとします。

一文一文に問題はありません。

でも、私なら、

 教室の窓から風が入った。ルミはノートを閉じた。
 考えてみる。
 働くって、なんだろう。

というように直します。

意味はほとんど変わりません。
変わっているのは、文章の呼吸です。

どこを続けるのか。
どこで切るのか。
どこに空白を置くのか。

現在の設定ファイルにも、「地の文は段落としてまとめる」「一文ごとに改行しない」というルールを置く一方、 心の反芻のように短文を連続させたい場合は例外としています。

ここで重要なのは、
短文が悪いわけではない
ということです。

短文を続ける場所と、続けない場所がある。
そこが文体です。

文体には「見た目」も含まれていた

文体というと、言葉遣いや文章表現を思い浮かべます。

でも、実際に作ってみると、それだけではありませんでした。

会話文のあとに地の文をどう続けるか。
地の文を何文くらい一つの段落にするか。
どこで改行するか。
地の文の段落は一字下げる。
会話文では一字下げしない。
会話文の最後に句点をつけるか、つけないか。

そうした画面で見たときの文章の形も、私にとっては文体の一部でした。

設定ファイルにも、段落の一字下げや、一文ごとに改行しないこと、 会話文の末尾には句点をつけないことなどを具体的に書いています。

一つ一つは小さなことです。

でも、それが積み重なると、読んだときの印象が変わります。

私には、
「自分ならこう書きたい」
という感覚があります。

同時に、
「自分ならこういう形で読みたい」
という感覚もあります。

この「自分なら」が、文体なのだと思います。

2.直した理由を、ルールに戻す

結局、手で直していた

AIが書いた文章を読んで、結局自分で直す。

文をつなげる。
逆に切る。
句読点を変える。
改行を変える。
会話のあとに地の文を置く。
同じ単語が続けば直す。

意味はほとんど変えず、文章の呼吸だけを変える。

そういう作業を何度もしていました。

でも、私はその手作業を減らすためにAIエージェントを使っているわけです。

AIが原稿を書き、そのあと全部自分で直していたら、なかなか自動化にはなりません。

そこで、手で直した内容を、
「次からAI自身が判断できないだろうか」
と考えるようになりました。

その結果、修正したことを一つずつルールへ戻していきました。

そうして「文体の憲法」ができた

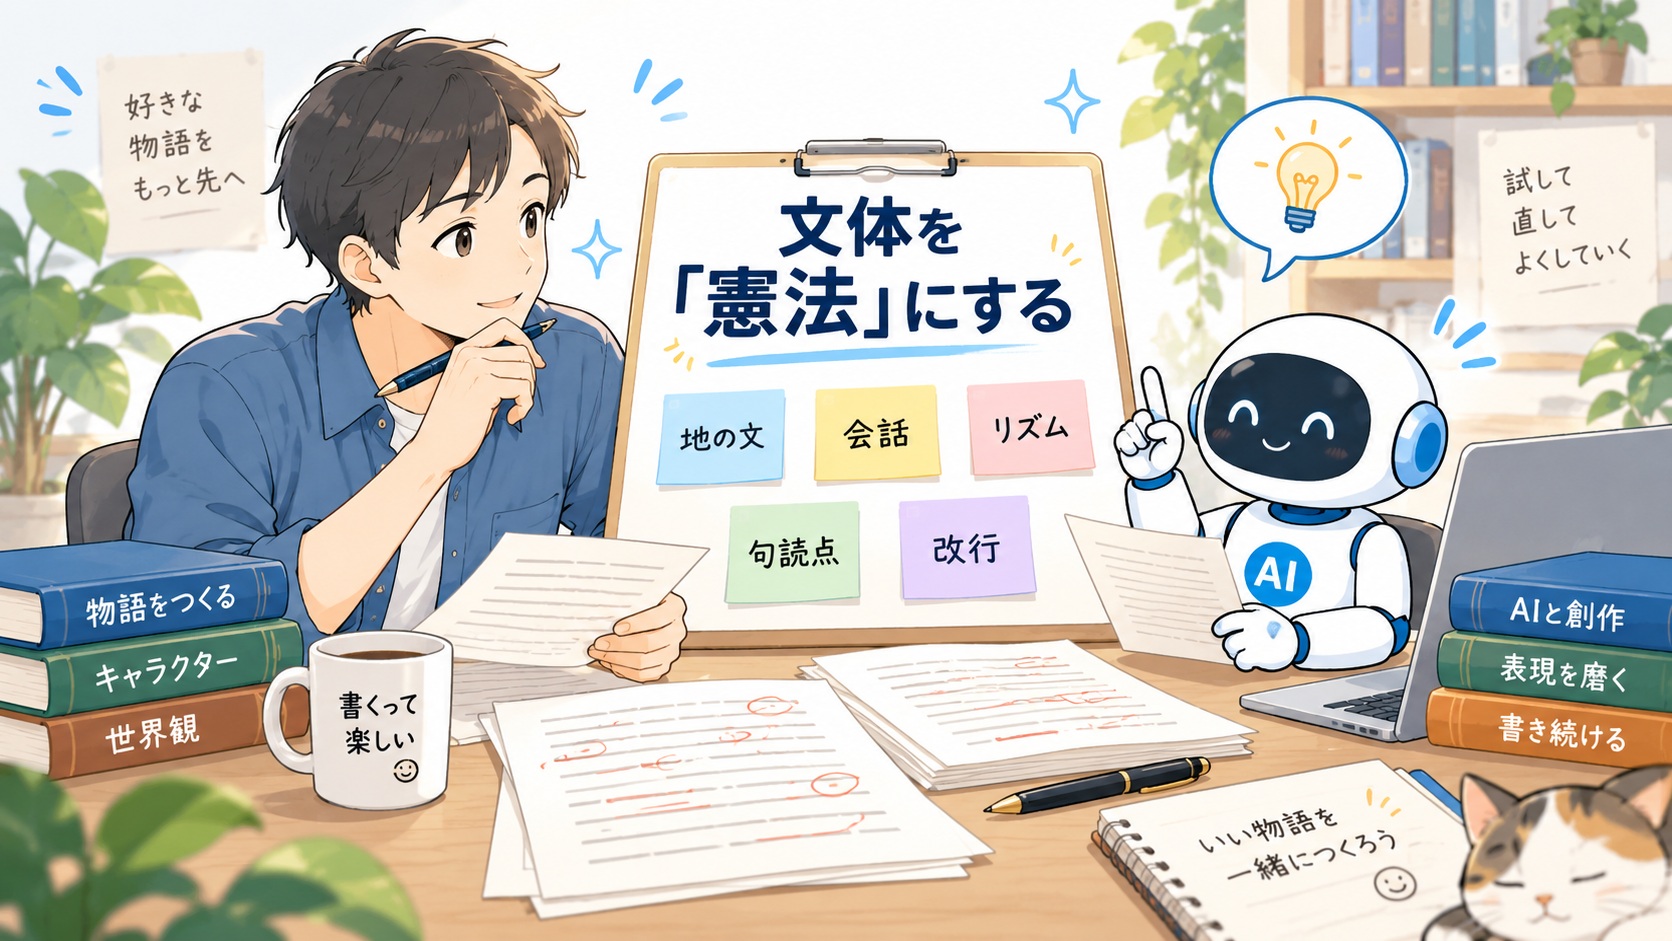
それが、style_constitution.md です。

最初から「文体の憲法を作ろう」と考えて、完成形を設計したわけではありません。

AIに書いてもらう。
読む。
違うと感じる。
自分で直す。
なぜ直したのかを考える。
次にも使えそうなら、ルールにする。

その繰り返しでできました。

このファイルの冒頭には、

このファイルは本作品の文体と描写の憲法である。
すべてのシーンはこのルールに従う。

と書いてあります。

「憲法」と呼んでいるのは、すべてを型にはめるためではありません。

複数の指示があったとき、
この作品では、最終的にどちらを選ぶのか
を決める上位の基準だからです。

禁止するなら、代わりに何を書くかも決める

文体の憲法を作る作業と、禁止事項を作る作業は、実際には別々ではありませんでした。

たとえば、この作品では感情を名前で直接説明しない、という境界を置いています。

しかし、
「感情を書いてはいけない」
だけでは、AIは困ります。

では何を書くのか。

感情を名前で呼ばない
→ 行動を書く
→ 沈黙を書く
→ 身体の動きを書く
→ 周囲の環境を書く

というように、禁止した表現には、できるだけ代わりに使う表現をセットで渡すようにしました。

実際の 07_forbidden.md にも、感情の直接表現を禁止したあと、 「ルミは窓の外を見た」のような行動、「莉子はそれ以上何も言わなかった」のような沈黙、 身体の動き、環境描写を代替手段として置いています。

これは、AIの自由を奪うための禁止ではありません。

「こちらへは行かない。その代わり、こちら側には広い表現の余地がある」
と示すための境界です。

文体の憲法と禁止事項は、片方が「書き方」、片方が「書いてはいけないこと」なのではなく、二つを合わせて初めて、
この作品では、何をどう書くのか
をAIに渡せるようになりました。

3.それでも、同じ文体にはならない

設定ファイルに書けるのは、文体の一部

では、style_constitution.md を渡せば、いつでも私の好きな文章が出てくるのか。

1年間使ってみた現在の答えは、
そうではない
です。

同じ設定ファイルを別のAIに渡したとしても、まったく同じ文体になるとは限りません。

むしろ、ならない可能性のほうが高いと思います。

なぜなら、設定ファイルに書けるものは、文体の一部だからです。

一文をどこで切るのか。
この句読点が気になるのか。
会話のあとに、どれくらい地の文が欲しいのか。
この段落は読みやすいのか。
少し説明しすぎなのか。

そこには、作者自身の好みがあります。

しかも、その好みを作者自身が最初から全部説明できるわけではありません。

私自身も、AIの文章を読んで初めて、
「自分はここが嫌なんだ」
と気づくことが何度もありました。

AIが作者を理解していく

だから最近は、少し考え方が変わってきました。

文体を設定ファイルだけでAIに渡すのではなく、
AIが作者のことを少しずつ理解していくことも必要なのではないか
と思っています。

AIが書く。
私が直す。
なぜ直したのかを伝える。
次にまた書く。
また直す。

その繰り返しの中で、
「この作者は、こういう文章を好む」
「ここでは切らない」
「ここでは説明しすぎない」
「こういう見た目の文章を読みやすいと感じる」
という判断基準が、少しずつ共有されていきます。

設定ファイルだけが文体を作っているのではありません。
設定ファイルと、作者と、AIとのやり取り。
その3つで少しずつ文体ができていく。

だから、仮に私の style_constitution.md をそのまま別の人が使ったとしても、 私と同じ文章ができるとは限りません。

同じルール。
同じ数値。
同じ構成。

それでも、作者が違えば、
「ここを直したい」
と思う場所が違います。

その修正の積み重ねが、またAIへ返っていきます。

作者とAIとの関係そのものが、作品の文体の一部になっていく。

これは、最初にAIで小説を書き始めたときには、考えていませんでした。

私はAIに、自分の文体を教えようとしていました。

でも実際には、
AIに文章を書いてもらい、
それを自分が直し、
その理由をAIに返すことで、
AIに自分を理解してもらう作業をしていた
とも言えます。

同時に、自分自身も、
「私はこういう文章が好きだったのか」
と知ることになりました。

文体の憲法は、完成品ではない

だから、style_constitution.md は完成した文体そのものではありません。

文体を自動生成する魔法のファイルでもありません。

作者の好みをAIへ伝えるための土台です。

そして、AIとのやり取りの中で、
書き換えられ、
追加され、
少しずつ精度が上がっていくものです。

この1年間、
書く、読む、直す、ルールにする。
その繰り返しでした。

文体については、今でも完全に機械化できたとは思っていません。

むしろ、まだ課題です。

でも、
「なぜこの文章が好きなのか」
「なぜこれは違うと思うのか」
を、以前よりAIと共有できるようになりました。

それだけでも、AIと長編小説を作るうえでは、大きな変化でした。

4.該当する設定ファイル

今回の中心になるのは、次の二つです。

style_constitution.md

文体と描写の最上位ルールです。 文章の基本トーン、文の長さ、地の文と会話の比率、段落、表記などをまとめています。 ファイル自身が「本作品の文体と描写の憲法である」と定義しています。

07_forbidden.md

作品の方向から外れやすい表現について、「何を避けるか」だけではなく、 必要なところでは「代わりに何を使うか」まで定めています。

この二つを組み合わせることで、
「どう書きたいか」と「そこから外れたとき、どちらへ戻すか」
をAIと共有しています。

経営に置き換えると

「これをやるな」だけの規則は、現場で機能しません。 やってはいけないことを決めたら、代わりに何をするのかまで決める。 そこまで書いて、初めてルールとして渡せます。

もう一つ。基準を数字にしても、数字を満たしただけでは望んだ結果になりません。 数字は測るためのものであって、判断そのものではない。 最後に人が見て、なぜ違うと思ったのかを言葉にし、それを基準へ戻す。 その往復がないと、基準は作った日のまま古びていきます。

そして次に問題になったのが、文章ではなく、人間そのものです。

文章のリズムをそろえることができても、登場人物の性格が途中で変わってしまえば、 長編小説は続きません。

1 2 3 4 5 6 7 8 9 10 ...